Maxun
L’alternative gratuite àScrapingBee
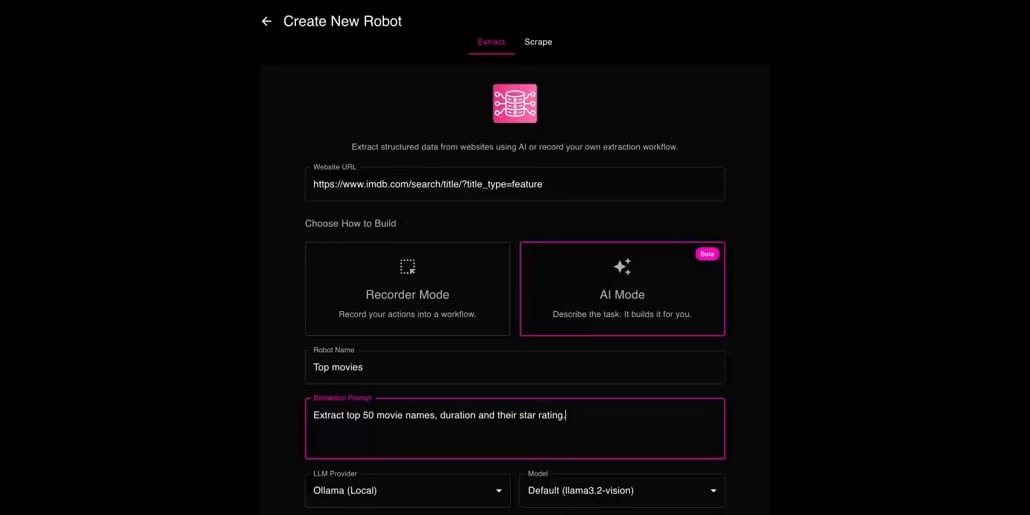
Maxun, c'est l'alternative open source à ScrapingBee : il transforme n'importe quel site en données propres, sans code. Tu crées un robot en cliquant sur ce que tu veux récupérer, et il refait le parcours à chaque passage, pages suivantes comprises. Ou tu le décris en une phrase et l'IA le construit, avec Claude, ChatGPT ou un modèle local via Ollama. Lance-le à heure fixe, même derrière une connexion, ou appelle-le comme ta propre API. Les résultats partent en CSV, dans Google Sheets, Airtable ou un webhook. Il s'installe en Docker Compose : prévois au moins 4 Go de mémoire libres et garde-le à jour. La limite : la rotation de proxies et le passage de captchas sont réservés à leur cloud. Sur les sites qui bloquent les robots, il te faut tes propres proxies, payants.
Face à ScrapingBee : le match
Prix
Maxun
0 € sur ta machine
ScrapingBee
17 €/mois (Hobby)
Pages par mois
Maxun
Illimitées
ScrapingBee
Environ 15 000 avec JavaScript
Sites protégés (proxies, captchas)
Maxun
Tes propres proxies, payants
ScrapingBee
Inclus
| VS | Maxun | ScrapingBee ↗ |
|---|---|---|
| Prix | 0 € sur ta machine | 17 €/mois (Hobby) |
| Pages par mois | Illimitées | Environ 15 000 avec JavaScript |
| Sites protégés (proxies, captchas) | Tes propres proxies, payants | Inclus |
| Sans code | Robots en cliquant ou décrits en une phrase | Une API à appeler depuis ton code |
| Extraction par IA | Claude, ChatGPT ou modèle local gratuit | 5 crédits de plus par page |
| Surveillance et passages programmés | Inclus | À programmer toi-même |
| Ce qu'il te faut | Docker et 4 Go de mémoire | Une clé d'API |
Comment l’installer (même en partant de zéro)
Cinq services Docker, dont un navigateur, sur ton ordinateur ou ton serveur. Le prompt installe la version gratuite depuis le dépôt officiel, branche un modèle d'IA pour le mode description et crée ton premier robot avec toi.
- 1
Colle ce prompt dans Claude (Code ou Desktop)
Il installe Maxun depuis le dépôt officiel, sécurise la configuration, branche l'IA et programme ton premier robot :
Installe Maxun sur ma machine : c'est la plateforme open source qui remplace ScrapingBee pour extraire des données de sites web (dépôt GitHub getmaxun/maxun, site maxun.dev). Vérifie d'abord que Docker est installé et que la machine a au moins 4 Go de mémoire libres. Suis ensuite le guide Docker Compose de la documentation (docs.maxun.dev) : récupère le docker-compose.yml et le fichier d'exemple des variables d'environnement du dépôt, remplace toutes les valeurs d'exemple par des mots de passe et des clés secrètes solides, et lance l'ensemble. Si c'est sur un serveur, place l'interface derrière mon nom de domaine en HTTPS. Pour le mode IA, branche ma clé Anthropic, ou installe Ollama si je préfère un modèle local gratuit. Crée ensuite avec moi un premier robot sur un site public de mon choix, en mode enregistrement puis en mode IA, et montre-moi comment exporter en CSV, envoyer les résultats dans Google Sheets et programmer un passage chaque jour. Explique-moi aussi quoi faire si un site bloque le robot (proxies), et comment mettre Maxun à jour. Explique chaque étape simplement, je débute.

Analyse le repo GitHub et regarde s'il est safe à installer par rapport à ma machine et mon infrastructure. Pose-moi un maximum de questions sous forme de widget pour clarifier ma demande et être le plus précis possible.
- 2
Commence par un site public
Teste sur un site sans protection anti robots : c'est là que la version gratuite fait tout. Pour un site qui te bloque, il faudra brancher des proxies dans les réglages.
- 3
Respecte les règles du site
Lis les conditions d'utilisation, espace tes passages pour ne pas surcharger le site, et fais attention au RGPD dès que tu récupères des données personnelles.
 Colle ce prompt dans Claude (Code ou Desktop)
Ce que tu en fais concrètement
Surveille les prix de tes concurrents
Un robot relève chaque jour les prix d'une boutique et envoie les résultats dans Google Sheets : ta veille tarifaire tourne toute seule.
Nourris Claude avec des pages propres
Maxun transforme une page ou un site entier en Markdown : Claude lit du texte propre au lieu d'un code plein de menus et de publicités.
Récupère une liste entière en un clic
Annonces, offres d'emploi, fiches produits : tu cliques sur un exemple, Maxun récupère toute la liste, pages suivantes comprises.
La santé du projet, en un coup d’œil
Avant d’installer un outil open source, une question compte : est-ce que le projet est vivant ? Ces scores sont calculés depuis les données publiques GitHub. Ce ne sont pas des notes en l’air.
80/100
ExcellentProjet très actif et bien entretenu : tu peux y aller sereinement.
- Activité
- 100
Est-ce que le code bouge ? (commits des 30 derniers jours)
- Maintenance
- 100
Depuis quand la dernière mise à jour ? Plus c’est frais, mieux c’est.
- Communauté
- 80
Étoiles et contributeurs : du monde autour = de l’aide et des correctifs.
- Maturité
- 90
L’âge du projet. Assez vieux pour être solide, encore vivant.
- Momentum
- 31
Le rythme du moment comparé à son rythme habituel : ça accélère ou ça s’endort ?
Le repo en chiffres
- Étoiles GitHub
- 18,3 k
- Forks
- 1,6 k
- Contributeurs
- 55
- Commits
- 7,8 k
- Âge du projet
- 3.1 ans
- Dernier commit
- il y a 5 j
- Taille
- 8 MB
- Licence
- AGPL-3.0
Construit avec
- TypeScript 93.4%
- JavaScript 6.4%
Scores calculés automatiquement depuis l’API GitHub (activité des 30 derniers jours, fraîcheur des mises à jour, taille de la communauté, âge du projet). Actualisés chaque jour.
L’avis de Loucash
7/10
Maxun a ce que ScrapingBee n'a pas : tu construis tes robots sans code, en cliquant sur la page ou en décrivant ce que tu veux en une phrase. Pour récupérer des données sur des sites publics, des prix, des annonces, des catalogues, c'est gratuit et sans limite de pages. Ce que j'apprécie : le mode IA avec un modèle local via Ollama, donc aucun coût par page, et le serveur MCP qui laisse Claude lancer les robots à ma place. Pourquoi 7 et pas plus : la version gratuite n'a pas ce que ScrapingBee fait payer, c'est-à-dire les proxies qui tournent et le passage des captchas. Sur un site qui bloque les robots, tu devras payer des proxies ou passer à leur cloud. Le projet est encore en version 0.0.47, avec une faille corrigée en juin 2026, donc les mises à jour sont obligatoires. Et il faut Docker et une machine avec de la mémoire.
C’est pour toi si : Tu veux récupérer régulièrement des données sur des sites publics (prix, annonces, catalogues, contenus pour Claude) sans coder ni payer à la page. Si tu dois extraire en masse des sites très protégés contre les robots, ScrapingBee ou un service de proxies restera nécessaire.
À voir aussi dans la bibliothèque
OpenSEO
Data & analytics134 € /moisL'outil SEO open source qui fait le travail de Semrush et Ahrefs : recherche de mots-clés, backlinks, suivi de positions, audit de site, visibilité dans les réponses des IA. Le logiciel est gratuit et s'héberge chez toi ; les données SEO se paient à l'usage, quelques centimes la requête, sans abonnement.
Voir la fiche →
Casdoor
Data & analytics31 € /moisLe serveur de connexion open source qui remplace Auth0 : page de connexion à tes couleurs, connexion Google et une centaine d'autres, double authentification, SSO d'entreprise. Tes comptes utilisateurs restent sur ton serveur, sans facture qui grimpe avec eux.
Voir la fiche →
PocketBase
Data & analytics22 € /moisUn backend complet dans un seul fichier : base SQLite, comptes utilisateurs, fichiers, temps réel et tableau de bord d'administration. Tu le lances sur ton serveur et tu as l'équivalent de Supabase ou Firebase, sans abonnement.
Voir la fiche →
Un mail par semaine qui te fait économiser
Chaque mardi : les alternatives open source qui viennent d’entrer dans la bibliothèque, ce qu’elles remplacent et ce qu’elles te font économiser. Un mail, pas plus.
Gratuit. Un mail le mardi. Désinscription en un clic. Tes données


Rejoins les lecteurs du mardi